
Nightmare作为一个封装号的Electron爬虫框架,并没有太多惊艳之处,只是封装。留作以后参考用吧
参考地址 基于 Electron 的爬虫框架 Nightmare
Electron 可以让你使用纯 JavaScript 调用 Chrome 丰富的原生的接口来创造桌面应用。你可以把它看作一个专注于桌面应用的 Node.js 的变体,而不是 Web 服务器。其基于浏览器的应用方式可以极方便的做各种响应式的交互,接下来介绍下关于 Electron 上衍生出的框架 Nightmare。
Nightmare 是一个基于 Electron 的框架,针对 Web 自动化测试和爬虫(其实爬虫这个是大家自己给这个框架加的功能XD),因为其具有跟 PlantomJS 一样的自动化测试的功能可以在页面上模拟用户的行为触发一些异步数据加载,也可以跟 Request 库一样直接访问 URL 来抓取数据,并且可以设置页面的延迟时间,所以无论是手动触发脚本还是行为触发脚本都是轻而易举的(这边注意,如果事件具备 isTrusted 的检查的话,就无法触发了)。
使用 Nightmare
为了更快速使用 NPM 下载,可以使用淘宝的镜像地址。直接 NPM 安装Nightmare 就完成安装了(二进制的 Electron 依赖有点大,安装时间可能比较长)。
写一个简单的启动 app.js;
const Nightmare = require('nightmare')const nightmare = new Nightmare({     show: true,     openDevTools: {         mode: 'detach'
     }
 })

 nightmare.goto('https://www.hujiang.com')
   .evaluate(function() {       // 该环境中能使用浏览器中的任何对象window/document,并且返回一个promise
     console.log('hello nightmare')     console.log('5 second close window')
   })
   .wait(5000)
   .end()
   .then(()=> {     console.log('close nightmare')
   })
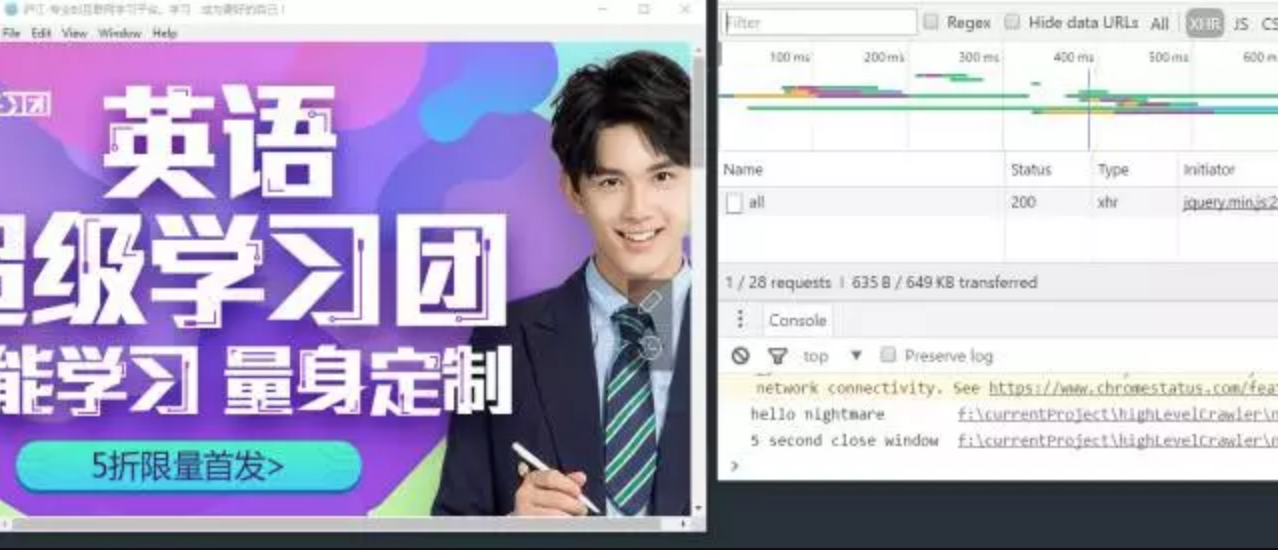
这个脚本会在打开的浏览器的调试控制台中打印出 hello nightmare 并且在5秒后关闭,随后在运行的该脚本的中输出 close nightmare。
Nightmare原理
利用了 Electron 提供的 Browser 的环境,同时具备了 Node.js 的 I/O 能力,所以可以很方便实现一个爬虫应用。Nightmare 的官网有更详细的介绍:
大致操作:
浏览器事件: goto,back,forward,refresh,
用户事件: click,mousedown,mouseup,mouseover,type,insert,select,check,uncheck,selectscrollTo
向网页注入脚本: .js .css的文件类型原理是跟油猴差不多,可以编写自己的js代码注入十分方便
wait 函数可以按照延迟时间或者一个 dom 元素的出现
evaluate 以浏览器的环境运行的脚本函数,然后返回一个 promise 函数
一个完整的nightmare爬虫应用
我们以抓取知乎上的话题的为应用场景,需要的数据是知乎的话题信息 包含以下字段 话题名称/话题的图片/关注者数量/话题数量/精华话题数量,但是因为后三者只能在其父亲话题中包含,所以必须先抓父话题才能抓取子话题,而且这些子话题是以 hover 的形式在父话题中异步加载的,如果用Request/Superagent 需要 HTTP 传递其解析过的id才能获取,但是用Nightmare 可以直接调用其 hover 事件触发数据的加载。
第一步获取需要抓取的话题深度,默认的根是现在知乎的根话题;
/**
* 抓取对应的话题页面的url和对应的深度保存到指定的文件名中
* @param {string} rootUrl - 顶层的url
* @param {int} deep - 抓取页面的深度
* @param {string} toFile - 保存的文件名
* @param {Function} cb - 完成后的回调
*/async function crawlerTopicsFromRoot (rootUrl, deep, toFile, cb) {
  rootUrl = rootUrl ||'https://www.zhihu.com/topic/19776749/hot'
  toFile = toFile || './topicsTree.json'
  console.time()  const result = await interactive
      .iAllTopics(rootUrl, deep)  console.timeEnd()
  util.writeJSONToFile(result['topics'], toFile, cb)
}

crawlerTopicsFromRoot('', 2, '', _ => {  console.log('完成抓取')
})
然后进行交互函数的核心函数,注意在开始抓取前,要去看看知乎的 robots.txt 文件看看哪些能抓和抓取的间隔不然很容易 timeout 的错误。
// 获取对应的话题的信息const cntObj = queue.shift()const url = `https://www.zhihu.com/topic/${cntObj['id']}/hot`const topicOriginalInfo = await nightmare
  .goto(url)
  .wait('.zu-main-sidebar') // 等待该元素的出现
  .evaluate(function () {   // 获取这块数据
      return document.querySelector('.zu-main-sidebar').innerHTML
  })// .....若干步的操作后// 获取其子话题的数值信息const hoverElement = `a.zm-item-tag[href$='${childTopics[i]['id']}']`const waitElement = `.avatar-link[href$='${childTopics[i]['id']}']`const topicAttached = await nightmare
  .mouseover(hoverElement) // 触发hover事件
  .wait(waitElement)
  .evaluate(function () {      return document.querySelector('.zh-profile-card').innerHTML
  })
  .then(val => {      return parseRule.crawlerTopicNumbericalAttr(val)
  })
  .catch(error => {      console.error(error)
  })
cheerio 是一个 jQuery 的 selector 库,可以应用于 HTML 片段并且获得对应的DOM 元素,然后我们就可以进行对应的 DOM 操作->增删改查都可以,这边主要用来查询 DOM 和获取数据。
const $ = require('cheerio')/** *抓取对应话题的问题数量/精华话题数量/关注者数量 */const crawlerTopicNumbericalAttr = function (html) {  const $ = cheerio.load(html)  const keys = ['questions', 'top-answers', 'followers']  const obj = {}
  obj['avatar'] = $('.Avatar.Avatar--xs').attr('src')
  keys.forEach(key => {
      obj[key] = ($(`div.meta a.item[href$=${key}] .value`).text() || '').trim()
  })  return obj
}/** * 抓取话题的信息 */const crawlerTopics = function (html) {  const $ = cheerio.load(html)  const  obj = {}  const childTopics = crawlerAttachTopic($, '.child-topic')
  obj['desc'] = $('div.zm-editable-content').text() || ''
  if (childTopics.length > 0) {
      obj['childTopics'] = childTopics
  }  return obj
}/** * 抓取子话题的信息id/名称 */const crawlerAttachTopic = function ($, selector) {  const topicsSet = []
  $(selector).find('.zm-item-tag').each((index, elm) => {      const self = $(elm)      const topic = {}
      topic['id'] = self.attr('data-token')
      topic['value'] = self.text().trim()
      topicsSet.push(topic)
  })  return topicsSet
}
然后一个简单的爬虫就完成了,最终获得部分数据格式如何:
{  "value": "rootValue",  "id": "19776749",  "fatherId": "-1",  "desc": "知乎的全部话题通过父子关系构成一个有根无循环的有向图。「根话题」即为所有话题的最上层的父话题。话题精华即为知乎的 Top1000 高票回答。请不要在问题上直接绑定「根话题」。这样会使问题话题过于宽泛。",  "cids": [      "19778317",      "19776751",      "19778298",      "19618774",      "19778287",      "19560891"
  ]
},
{  "id": "19778317",  "value": "生活、艺术、文化与活动",  "avatar": "https://pic4.zhimg.com/6df49c633_xs.jpg",  "questions": "3.7M",  "top-answers": "1000",  "followers": "91K",  "fid": "19776749",  "desc": "以人类集体行为和人类社会文明为主体的话题,其内容主要包含生活、艺术、文化、活动四个方面。",  "cids": [      "19551147",      "19554825",      "19550453",      "19552706",      "19551077",      "19550434",      "19552266",      "19554791",      "19553622",      "19553632"
  ]
},
总结
Nightmare 作为爬虫的最大优势是只需要知道数据所在页面的 URL 就可以获取对应的同步/异步数据,并不需要详细的分析 HTTP 需要传递的参数。只需要知道进行哪些操作能使得网页页面数据更新,就能通过获取更新后的 HTML 片段获得对应的数据,在 Demo 中的 Nightmare 是打开了 chrome-dev 进行操作的,但是实际运行的时候是可以关闭的,关闭了之后其操作的速度会有一定的上升。下面的项目中还包含了另外一个爬取的知乎的动态。
Demo源码地址: https://github.com/williamstar/nightmare-demo